18 नवंबर 2026 को सिक्योरिटी रिसर्चर्स ने nginx में 2 critical vulnerabilities का खुलासा किया। nginx इंटरनेट पर सबसे ज़्यादा इस्तेमाल होने वाले वेब सर्वर्स में से एक है। पिछले एक दशक की हर nginx रिलीज़ इससे प्रभावित है, इसलिए दुनिया भर की उन सभी कंपनियों को अपडेट करना पड़ा जो HTTP/2 enabled के साथ इसे चला रही थीं।
अगली सुबह हमारे एक DevOps इंजीनियर ने टीम के साथ Wiz Research का विश्लेषण शेयर किया और पूछा कि हमारे कौन-से सिस्टम्स को अपडेट की ज़रूरत है। उसी वर्किंग डे के अंत तक Pushwoosh प्लेटफॉर्म को सर्व करने वाला हर internet-facing nginx instance अपडेट और वेरिफ़ाई हो चुका था। अगले दिन हुए internal audit में exploitation का कोई संकेत नहीं मिला।
Pushwoosh एक omnichannel कस्टमर एंगेजमेंट प्लेटफॉर्म है, और हमारे कस्टमर्स के ऐप्स चौबीसों घंटे हमारे edge के ज़रिए API ट्रैफ़िक भेजते हैं। जब इस तरह का वेब सर्वर bug सार्वजनिक होता है, तो हम उसे कितनी जल्दी बंद करते हैं, यह उनमें से हर एक के लिए मायने रखता है। आगे पढ़िए कि क्या खुलासा हुआ, हमने क्या किया, एक इंजीनियर और AI एजेंट्स के एक सेट ने काम कैसे बाँटा, और हमने क्या सीखा।
क्या खुलासा हुआ
| CVE | यह क्या है | प्रभावित nginx OSS | इसमें फ़िक्स हुआ |
|---|---|---|---|
| CVE-2026-123007 | HTTP/2 flow control (send_window) में integer underflow | 1.9.5 से 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
| CVE-2026-123633 | Reverse-proxy मोड में HTTP/2 कनेक्शन का use-after-free | 1.19.7 से 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
send_window) में integer underflowदोनों को CVSS 4.0 स्कोर 9.2 के साथ critical रेट किया गया है। उसी रिलीज़ ने HTTP/3, mail proxy, DNS resolver और stream मॉड्यूल्स में 8 और CVE भी बंद किए।
इन्हें exploit करना मुश्किल है: इसके लिए memory leak और सावधानी से heap grooming की ज़रूरत होती है, और Wiz ने अपना exploit code पब्लिश नहीं किया, हालाँकि कुछ सिक्योरिटी वेंडर्स ने जल्द ही public exploits की रिपोर्ट की। फिर भी हमने इसे urgent माना। ये bugs बिना authentication के remote code execution की इजाज़त देते हैं, हमारे लगभग सभी public endpoints पर HTTP/2 चालू था, और TLS terminators private keys को memory में रखते हैं। हमने अगली maintenance window का इंतज़ार करने के बजाय 1 से 2 दिनों के भीतर पैच करने का फ़ैसला किया।
👉 पूरा तकनीकी विश्लेषण: NGINX HTTP/2 RCE vulnerabilities, Wiz Research
हमारा रिस्पॉन्स, स्टेप बाय स्टेप
1. पहले exposure मैप करें
कुछ भी छूने से पहले हमने पूरे फ़्लीट को read-only मोड में स्कैन किया: edge routing, TLS termination, internal services और Kubernetes ingress controllers। हर instance के लिए हमने nginx वर्ज़न और यह दर्ज किया कि HTTP/2 चालू है या नहीं।
इससे हमें असली exposure पर आधारित प्रायोरिटी लिस्ट मिली। साथ ही कुछ ऐसे internal hosts भी सामने आए जो सालों पुराने nginx वर्ज़न पर चल रहे थे।
2. छिपी हुई dependencies ढूँढें
nginx को अपग्रेड करना शायद ही कभी सिर्फ़ nginx को अपग्रेड करना होता है।
हमारे builds में metrics, geolocation और WAF के लिए custom dynamic modules होते हैं, और nginx सिर्फ़ वही मॉड्यूल लोड करता है जो उसके exact वर्ज़न के लिए बना हो। हर मॉड्यूल को 1.30.7 के लिए, हमारे इस्तेमाल किए जाने वाले हर CPU आर्किटेक्चर पर, दोबारा build करना पड़ा।
ARM सबसे मुश्किल हिस्सा था: हमारा dedicated ARM build runner एक हफ़्ते पहले ही retire किया गया था। हमने उन builds को shared CI में emulated cross-builds पर शिफ़्ट किया। हर build में कुछ मिनटों के बजाय 25 मिनट तक लगे, जो परेशान करने वाला था, लेकिन इसके लिए नए हार्डवेयर की ज़रूरत नहीं पड़ी।
3. जब अपग्रेड का विकल्प न हो, तो backport करें
हमारा Kubernetes ingress controller एक frozen upstream पर बना है, जो अपना nginx वर्ज़न pin करता है और अपने दर्जनों patches साथ रखता है। इसे nginx 1.30 पर ले जाना एक अलग प्रोजेक्ट बन जाता।
इसलिए हमने nginx 1.30.6 और 1.30.7 के बीच का official security diff लिया और उसे controller के nginx पर लागू किया। यह सभी upstream patches के ऊपर साफ़-साफ़ लग गया, और जिस एक जगह मैच पूरी तरह exact नहीं था, उसे हमने हाथ से जाँचा। वर्ज़न string अब भी 1.27.1 दिखाती है, जबकि उसके नीचे का HTTP/2 code 1.30.7 से मेल खाता है।
4. रिव्यू से होकर शिप करें, blast radius के हिसाब से रोल आउट करें
हर बदलाव automated code और security review के साथ एक merge request से होकर गया: module packages, install role, ingress image, version pins। हमारे playbooks से मैनेज होने वाले hosts में बदलाव सिर्फ़ उन्हीं merge requests के ज़रिए किए गए।
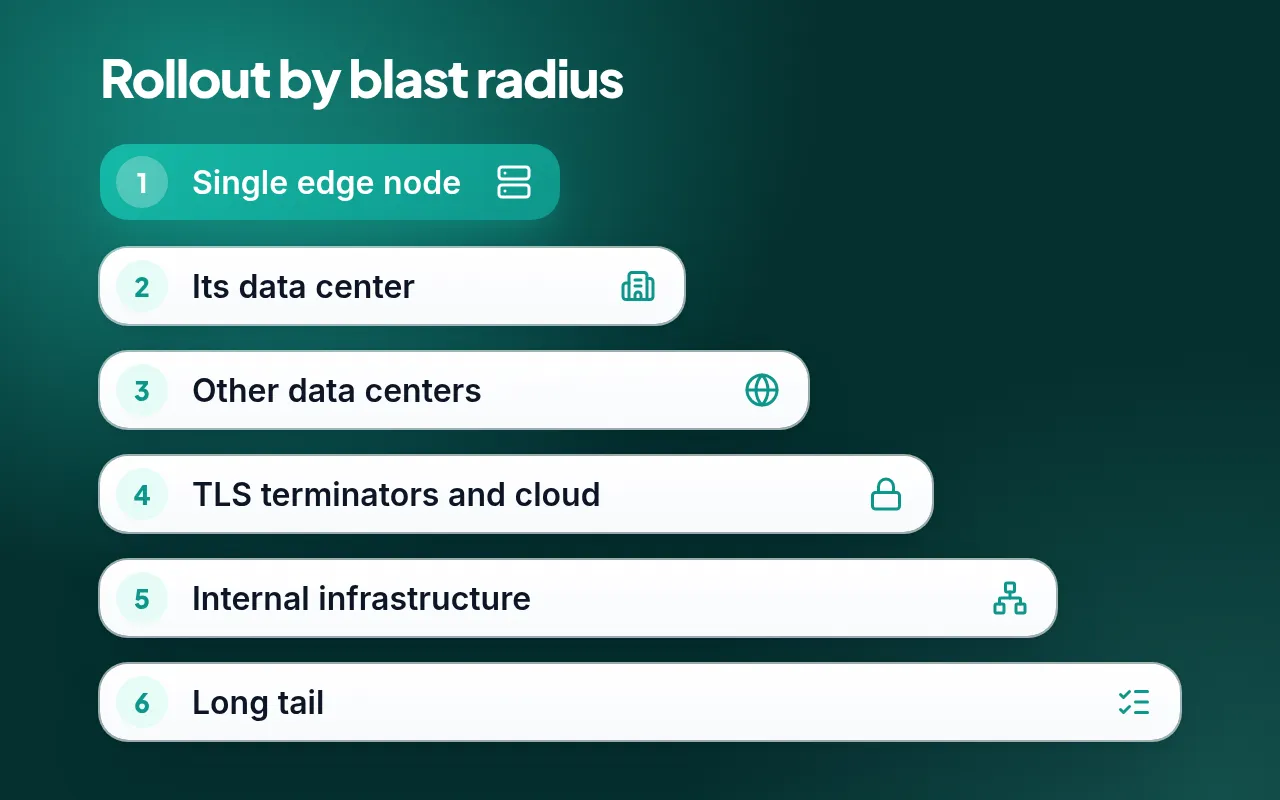
हमने एक बार में 1 host पर रोल आउट किया, उन जगहों से शुरू करके जहाँ failure से सबसे कम नुकसान होता। पहले एक data center का एक single edge node, जिसे बाहर से HTTP/2 पर चेक किया गया। फिर उस data center का बाकी हिस्सा, दूसरे data centers, TLS terminators और cloud hosts, और सबसे आख़िर में access bastion।
हर host पर playbook ने पहले और बाद में config test चलाया, nginx को सिर्फ़ तभी restart किया जब binary बदली हो, और कन्फ़र्म किया कि नई binary सभी modules लोड करके, काम करते TLS handshake और साफ़ error log के साथ चल रही है।
Kubernetes ingress को Helm के ज़रिए रोल आउट किया गया। Apply से पहले हमने live release की तुलना git से की और server-side dry run चलाया, और नए controllers ने पुराने controllers को एक-एक node करके replace किया।
5. Long tail को बंद करें
कुछ hosts हमारे मुख्य automation से बाहर थे, ज़्यादातर internal tools और distro packages पर चलने वाले VPN nodes। HTTP/2 बंद कर देना एक तेज़ और officially recommended अस्थायी उपाय होता। पता चला कि हमारे इस्तेमाल किए जाने वाले हर OS वर्ज़न के लिए fixed packages मौजूद थे, इसलिए हमने इन hosts को भी 1.30.7 पर अपग्रेड किया, एक-एक करके और पहले config backup लेकर।
इनके साथ भी अपने सरप्राइज़ आए। पुराने distro module packages को पहले हटाना पड़ा, वरना नया nginx config test में फ़ेल हो जाता। पूरे समय पुराना process ट्रैफ़िक सर्व करता रहा, इसलिए कुछ भी डाउन नहीं हुआ। कुछ nodes को अपग्रेड से पहले नए OpenSSL की भी ज़रूरत पड़ी।
जिस खोज से हम सबसे ज़्यादा ख़ुश हैं: 1 provisioning role में पुराना default nginx वर्ज़न था और downgrades की इजाज़त थी। उसका अगला routine run चुपचाप फ़िक्स को रोल बैक कर देता। अब एक अलग merge request वर्ज़न को code में pin करता है।
💡 किसी भी manual फ़िक्स के बाद चेक करें कि आपका अपना automation उसे undo न कर दे।
काम कैसे ऑर्गनाइज़ किया गया
1 DevOps इंजीनियर ने AI एजेंट्स के साथ मिलकर रिस्पॉन्स चलाया, जिनमें से हर एक प्रोसेस के एक सीमित हिस्से के लिए ज़िम्मेदार था: execution, task routing, code review, releases और access approval। एजेंट्स ने वह दोहराव वाला काम संभाला जिसे वेरिफ़ाई करना आसान है, जैसे discovery, builds, merge requests, rollout और post-change checks।
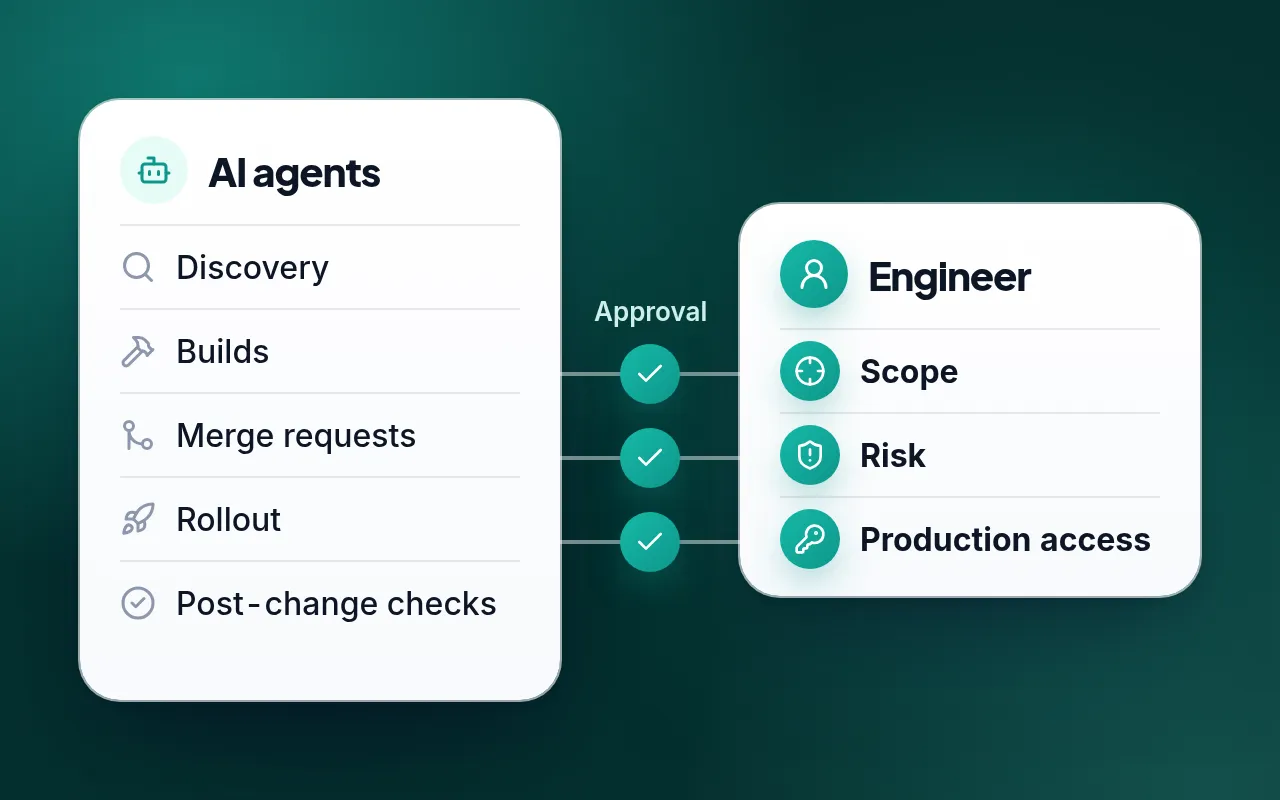
फ़ैसले इंजीनियर के हाथ में रहे। Scope, risk और production access उसके फ़ैसले थे, और scope सिर्फ़ टीम थ्रेड में उसकी स्पष्ट मंज़ूरी के बाद ही बढ़ा।
Access भी इसी मॉडल पर चला। Elevated access हर command के लिए नहीं, बल्कि काम के हर stage के लिए दिया गया, वह भी सिर्फ़ इंजीनियर की approval के बाद, और working window बंद होते ही वह expire हो गया।
इसी बँटवारे ने एक दिन में काम पूरा करना संभव बनाया: 1 व्यक्ति पूरे फ़्लीट को कवर कर सका, जबकि हर बदलाव फिर भी review और इंसानी फ़ैसले से होकर गुज़रा।
नतीजा
| कब | क्या हुआ |
|---|---|
| 18 नवंबर | F5 ने फ़िक्स रिलीज़ किए, vulnerabilities का सार्वजनिक खुलासा हुआ |
| 19 नवंबर, सुबह | इंजीनियर ने Wiz का विश्लेषण शेयर किया, exposure मैपिंग शुरू हुई |
| 19 नवंबर, दोपहर | सभी आर्किटेक्चर के लिए modules दोबारा build हुए, ingress image में backport हुआ, बदलाव review होकर merge हुए |
| 19 नवंबर, दोपहर बाद | चरणबद्ध रोलआउट: edge, TLS terminators, cloud hosts, bastion, internal tools और VPN nodes |
| 19 नवंबर, दिन के अंत तक | Pushwoosh प्लेटफॉर्म को सर्व करने वाला हर internet-facing nginx instance पैच और वेरिफ़ाई हुआ |
| 20 नवंबर | Internal audit बिना exploitation के किसी संकेत के पूरा हुआ, status page पर security notice पब्लिश हुआ |
- 30 से ज़्यादा hosts nginx 1.30.7 पर ले जाए गए और लाइव चेक किए गए, जिनमें ARM मशीनें भी शामिल हैं।
- Pushwoosh के दोनों production Kubernetes clusters में ingress backported image पर चल रहा है।
- 20 नवंबर को पूरे हुए internal audit में exploitation का कोई संकेत नहीं मिला।
Pushwoosh कस्टमर्स के लिए इसका क्या मतलब है
Pushwoosh प्लेटफॉर्म के लिए आपकी तरफ़ से कोई action ज़रूरी नहीं है, और हमारे Mobile और Web SDKs प्रभावित नहीं हैं। विवरण हमारे status page पर security notice में है, और पूरी Security Advisory PW-SA-2026-003 support@pushwoosh.com पर अनुरोध करके उपलब्ध है।
अगर आपके अपने सिस्टम्स HTTP/2 enabled के साथ nginx, NGINX Plus या ingress-nginx चलाते हैं, तो हम nginx 1.30.7, 1.31.9 या उससे नए वर्ज़न पर अपडेट करने की सलाह देते हैं।
हर टीम को हमारी सलाह
- ज़रूरत पड़ने से पहले अपना exposure जानें। हमारा पहला घंटा “कौन-से सिस्टम्स प्रभावित हैं” का जवाब ढूँढने में गया। वर्ज़न्स और सेटिंग्स की अप-टू-डेट inventory के साथ इसमें मिनट लगते हैं।
- Dynamic modules हर पैच की छिपी हुई dependency हैं। अपग्रेड शेड्यूल करने से पहले हर मॉड्यूल और हर आर्किटेक्चर के rebuild का समय बजट करें, ख़ासकर ऐसे आर्किटेक्चर के लिए जिसका कोई dedicated build runner नहीं है।
- Security diff को backport करना एक जायज़ तरीका है। अगर frozen upstream अपग्रेड को रोक रहा है, तो जो वर्ज़न आप पहले से चला रहे हैं उस पर official फ़िक्स लागू करके उसी दिन risk बंद किया जा सकता है।
- पक्का करें कि automation आपके फ़िक्स को undo न करे। ऐसे roles ढूँढें जिनमें default वर्ज़न हो और downgrades की इजाज़त हो। हमारे एक role ने अपने अगले routine run में एक दिन का काम उलट दिया होता।
- Scope के फ़ैसले इंसानों के पास रखें, और access को time-boxed रखें। हर command के बजाय हर stage के लिए 1 time-boxed access grant का मतलब है कम approval क्लिक्स, और काम पूरा होते ही access ख़त्म हो जाता है।
Pushwoosh के साथ कस्टमर्स का भरोसा सुरक्षित रखें
किसी critical CVE पर रिस्पॉन्स इस बारे में नहीं है कि कोई कितनी तेज़ी से टाइप कर सकता है। यह इस बारे में है कि advisory आने से पहले inventory, pipeline और review process तैयार हों।
हम Pushwoosh से होकर गुज़रने वाली हर चीज़ पर, जिसमें आपके मैसेजेस और यूज़र डेटा शामिल हैं, यही अनुशासन लागू करते हैं। अगर आप जानना चाहते हैं कि हम आपके ऐप की सिक्योरिटी कैसे संभालते हैं, तो हमारी टीम से बात करें।
संबंधित लेख
सभी देखें