Em 18 de novembro de 2026, pesquisadores de segurança divulgaram 2 vulnerabilidades críticas no nginx, um dos servidores web mais usados da internet. Todas as versões do nginx da última década são afetadas, então empresas do mundo todo que o usam com HTTP/2 ativado precisaram atualizar.
Na manhã seguinte, um dos nossos engenheiros de DevOps compartilhou a análise da Wiz Research com o time e perguntou quais dos nossos sistemas precisavam da atualização. Até o fim daquele dia de trabalho, cada instância do nginx exposta à internet que atende a plataforma Pushwoosh estava atualizada e verificada. Uma auditoria interna no dia seguinte não encontrou sinais de exploração.
A Pushwoosh é uma plataforma omnichannel de engajamento de clientes, e os apps dos nossos clientes enviam tráfego de API pelo nosso edge 24 horas por dia. Quando um bug de servidor web como esse se torna público, a rapidez com que o fechamos importa para cada um deles. Veja aqui o que foi divulgado, o que fizemos, como um engenheiro e um conjunto de agentes de IA dividiram o trabalho e o que aprendemos.
O que foi divulgado
| CVE | O que é | nginx OSS afetado | Corrigido em |
|---|---|---|---|
| CVE-2026-123007 | Integer underflow no controle de fluxo do HTTP/2 (send_window) | 1.9.5 a 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
| CVE-2026-123633 | Use-after-free de uma conexão HTTP/2 no modo de proxy reverso | 1.19.7 a 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
send_window)As duas são classificadas como críticas, com pontuação CVSS 4.0 de 9.2. A mesma versão também corrigiu mais 8 CVEs no HTTP/3, no proxy de e-mail, no resolvedor de DNS e nos módulos stream.
A exploração é difícil: exige um vazamento de memória e uma preparação cuidadosa do heap (heap grooming), e a Wiz não publicou seu código de exploit, embora alguns fornecedores de segurança logo tenham relatado exploits públicos. Mesmo assim, tratamos o caso como urgente. Os bugs permitem execução remota de código sem autenticação, o HTTP/2 estava ativo em quase todos os nossos endpoints públicos e os terminadores TLS mantêm chaves privadas na memória. Decidimos aplicar o patch em 1 a 2 dias em vez de esperar a próxima janela de manutenção.
👉 Análise técnica completa: NGINX HTTP/2 RCE vulnerabilities, Wiz Research
Nossa resposta, passo a passo
1. Primeiro, mapear a exposição
Antes de mexer em qualquer coisa, varremos toda a frota em modo somente leitura: roteamento de edge, terminação TLS, serviços internos e os ingress controllers do Kubernetes. Para cada instância, registramos a versão do nginx e se o HTTP/2 estava ativo.
Isso nos deu uma lista de prioridades baseada na exposição real. Também revelou alguns hosts internos com versões do nginx de anos atrás.
2. Encontrar as dependências ocultas
Atualizar o nginx raramente é só atualizar o nginx.
Nossos builds incluem módulos dinâmicos próprios para métricas, geolocalização e WAF, e o nginx só carrega um módulo compilado para a sua versão exata. Cada módulo precisou ser recompilado para a 1.30.7, em cada arquitetura de CPU que usamos.
O ARM foi a parte chata: nosso runner de build dedicado para ARM tinha sido desativado uma semana antes. Passamos esses builds para cross-builds emulados no CI compartilhado. Cada um levava até 25 minutos em vez de um ou dois. Foi irritante, mas não exigiu hardware novo.
3. Fazer backport quando atualizar não é uma opção
Nosso ingress controller do Kubernetes é baseado em um upstream congelado que fixa a versão do nginx e carrega dezenas de patches próprios. Migrá-lo para o nginx 1.30 seria um projeto à parte.
Então pegamos o diff de segurança oficial entre o nginx 1.30.6 e o 1.30.7 e o aplicamos ao nginx do controller. Ele entrou de forma limpa sobre todos os patches upstream, e conferimos à mão o único trecho duvidoso. A string de versão ainda diz 1.27.1, enquanto o código HTTP/2 por baixo corresponde ao 1.30.7.
4. Entregar com revisão, fazer o rollout pelo raio de impacto
Cada mudança passou por um merge request com revisão automatizada de código e de segurança: pacotes de módulos, a role de instalação, a imagem do ingress, as versões fixadas. Os hosts gerenciados pelos nossos playbooks foram alterados apenas por meio desses merge requests.
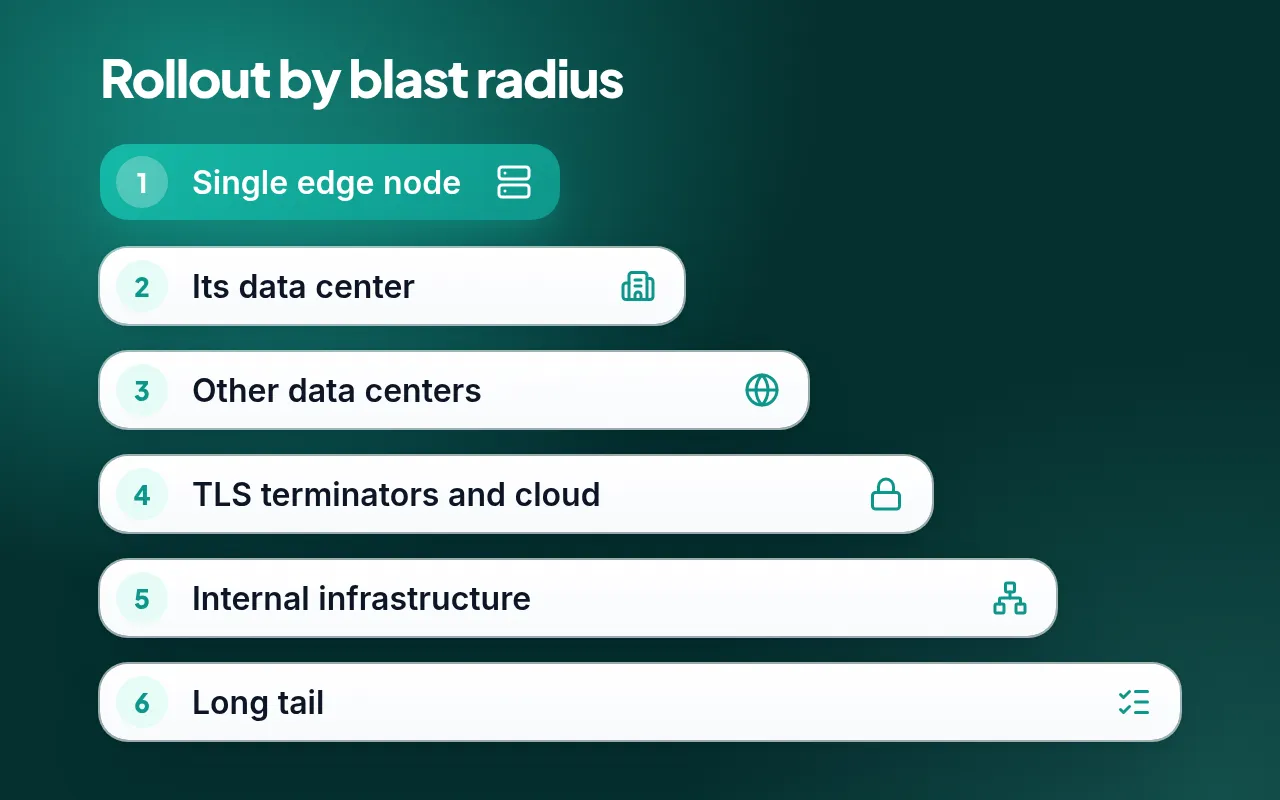
Fizemos o rollout 1 host por vez, começando onde uma falha causaria menos dano. Primeiro, um único nó de edge em um data center, verificado de fora via HTTP/2. Depois, o resto desse data center, os demais data centers, os terminadores TLS e os hosts em nuvem, com o bastion de acesso por último.
Em cada host, o playbook rodava o teste de configuração antes e depois, reiniciava o nginx só se o binário tivesse mudado e confirmava que o novo binário estava rodando com todos os módulos carregados, um handshake TLS funcionando e um log de erros limpo.
O ingress do Kubernetes foi atualizado via Helm. Antes do apply, comparamos a release em produção com o git e rodamos um dry run no lado do servidor, e os novos controllers substituíram os antigos um nó por vez.
5. Fechar a cauda longa
Alguns hosts ficavam fora da nossa automação principal, principalmente ferramentas internas e nós de VPN com pacotes da distribuição. Desativar o HTTP/2 teria sido a solução paliativa rápida e oficialmente recomendada. Mas havia pacotes corrigidos para todas as versões de sistema operacional que usamos, então também atualizamos esses hosts para a 1.30.7, um de cada vez e com backup da configuração antes.
Eles trouxeram suas próprias surpresas. Os pacotes de módulos antigos da distribuição precisavam ser removidos primeiro, senão o novo nginx falhava no teste de configuração. O processo antigo continuou atendendo o tráfego o tempo todo, então nada caiu. Alguns nós também precisaram de um OpenSSL mais novo antes da atualização.
A descoberta que mais nos deixou aliviados: 1 role de provisionamento tinha uma versão antiga do nginx como padrão e permitia downgrades. Sua próxima execução de rotina teria revertido o fix silenciosamente. Um merge request separado agora fixa a versão no código.
💡 Depois de qualquer fix manual, confira se a sua própria automação não vai desfazê-lo.
Como o trabalho foi organizado
1 engenheiro de DevOps conduziu a resposta junto com agentes de IA, cada um responsável por uma parte específica do processo: execução, distribuição de tarefas, revisão de código, releases e aprovação de acessos. Os agentes cuidaram do trabalho repetitivo e fácil de verificar, como levantamento, builds, merge requests, rollout e checagens pós-mudança.
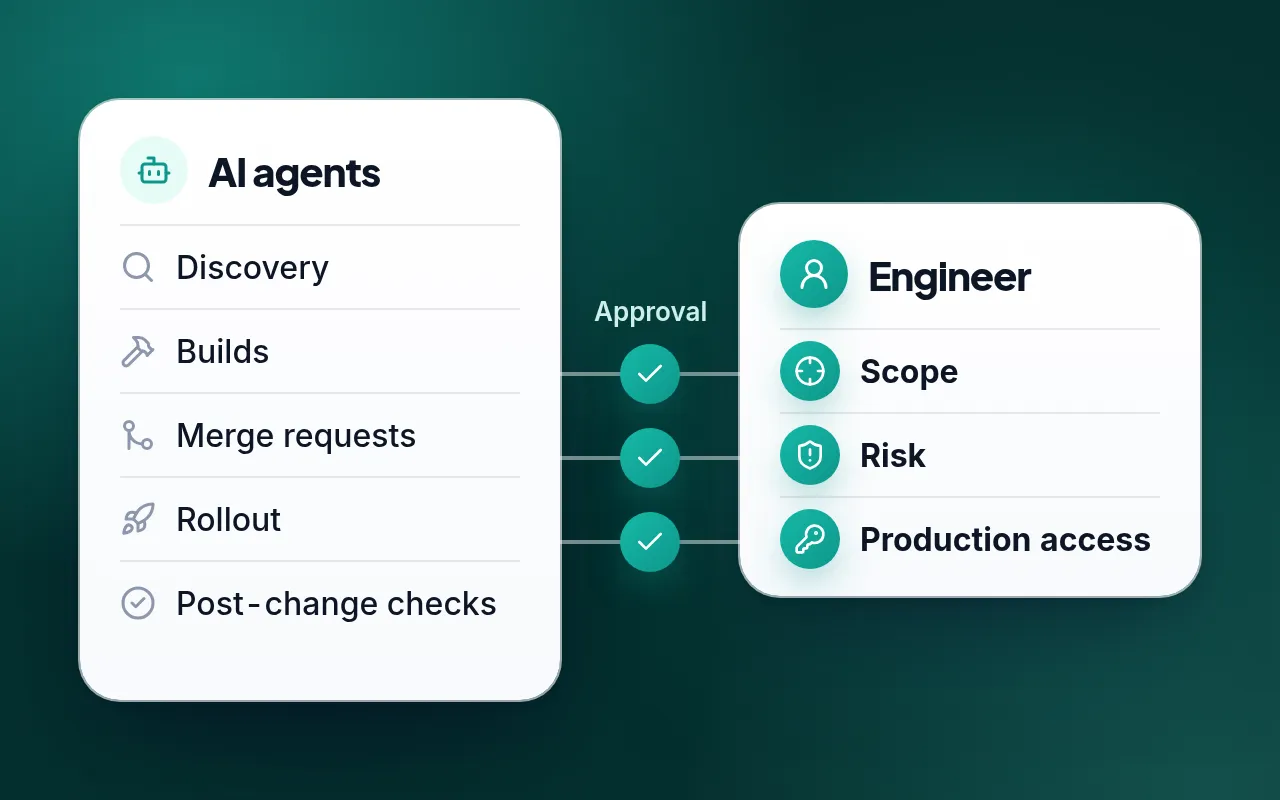
As decisões ficaram com o engenheiro. Escopo, risco e acesso à produção eram decisões dele, e o escopo só aumentou depois do seu sinal verde explícito na thread do time.
O acesso seguiu o mesmo modelo. Permissões elevadas eram concedidas por etapa do trabalho, não por comando, só depois da aprovação do engenheiro, e expiravam quando a janela de trabalho se fechava.
Essa divisão é o que tornou possível resolver tudo em um dia: 1 pessoa conseguiu cobrir a frota inteira, enquanto cada mudança ainda passava por revisão e por uma decisão humana.
O resultado
| Quando | O que aconteceu |
|---|---|
| 18 de nov. | A F5 lança as correções, as vulnerabilidades são divulgadas publicamente |
| 19 de nov., manhã | O engenheiro compartilha a análise da Wiz, começa o mapeamento da exposição |
| 19 de nov., meio-dia | Módulos recompilados para todas as arquiteturas, backport aplicado à imagem do ingress, mudanças revisadas e mergeadas |
| 19 de nov., tarde | Rollout em etapas: edge, terminadores TLS, hosts em nuvem, bastion, ferramentas internas e nós de VPN |
| 19 de nov., fim do dia | Cada instância do nginx exposta à internet que atende a plataforma Pushwoosh corrigida e verificada |
| 20 de nov. | Auditoria interna concluída sem sinais de exploração, aviso de segurança publicado na página de status |
- Mais de 30 hosts migrados para o nginx 1.30.7 e verificados em produção, incluindo máquinas ARM.
- O ingress dos dois clusters Kubernetes de produção da Pushwoosh roda com a imagem com backport.
- Uma auditoria interna concluída em 20 de novembro não encontrou sinais de exploração.
O que isso significa para os clientes da Pushwoosh
Você não precisa fazer nada em relação à plataforma Pushwoosh, e nossos SDKs Mobile e Web não são afetados. Os detalhes estão no nosso aviso de segurança na página de status, e o Security Advisory completo PW-SA-2026-003 está disponível mediante solicitação em support@pushwoosh.com.
Se os seus próprios sistemas usam nginx, NGINX Plus ou ingress-nginx com HTTP/2 ativado, recomendamos atualizar para o nginx 1.30.7, 1.31.9 ou posterior.
O que diríamos a qualquer time
- Conheça sua exposição antes de precisar dela. Nossa primeira hora foi para responder “quais sistemas são afetados”. Com um inventário atualizado de versões e configurações, isso leva minutos.
- Módulos dinâmicos são uma dependência oculta de todo patch. Reserve tempo para recompilar cada módulo e cada arquitetura antes de agendar a atualização, principalmente para uma arquitetura sem runner de build dedicado.
- Fazer backport de um diff de segurança é uma ferramenta legítima. Se um upstream congelado bloqueia a atualização, aplicar a correção oficial à versão que você já usa pode eliminar o risco no mesmo dia.
- Garanta que a automação não vai desfazer seu fix. Procure roles com versão padrão e downgrades permitidos. Uma das nossas teria revertido um dia de trabalho na próxima execução de rotina.
- Deixe as decisões de escopo com pessoas e limite o acesso no tempo. 1 acesso temporário por etapa, e não por comando, significa menos cliques de aprovação, e o acesso desaparece quando o trabalho termina.
Proteja a confiança dos seus clientes com a Pushwoosh
Responder a uma CVE crítica não tem a ver com a velocidade de digitação de alguém. Tem a ver com ter o inventário, o pipeline e o processo de revisão prontos antes de o advisory sair.
Aplicamos a mesma disciplina a tudo o que passa pela Pushwoosh, incluindo suas mensagens e os dados dos seus usuários. Se quiser saber como cuidamos da segurança do seu app, fale com o nosso time.
Artigos relacionados
Ver todos