Am 18. November 2026 haben Sicherheitsforscher 2 kritische Schwachstellen in nginx offengelegt, einem der meistgenutzten Webserver im Internet. Betroffen ist jedes nginx-Release der vergangenen zehn Jahre. Unternehmen weltweit, die nginx mit aktiviertem HTTP/2 betreiben, mussten deshalb aktualisieren.
Am nächsten Morgen teilte einer unserer DevOps-Engineers die Analyse von Wiz Research mit dem Team und fragte, welche unserer Systeme das Update brauchen. Bis zum Ende dieses Arbeitstages war jede öffentlich erreichbare nginx-Instanz der Pushwoosh-Plattform aktualisiert und geprüft. Ein internes Audit am Folgetag fand keine Anzeichen einer Ausnutzung.
Pushwoosh ist eine Omnichannel-Plattform für Kundenbindung, und die Apps unserer Kunden senden rund um die Uhr API-Traffic über unsere Edge. Wenn ein solcher Webserver-Fehler öffentlich wird, zählt für jeden von ihnen, wie schnell wir ihn schließen. Hier lesen Sie, was offengelegt wurde, was wir getan haben, wie sich ein Engineer und eine Reihe von KI-Agenten die Arbeit aufgeteilt haben und was wir daraus gelernt haben.
Was offengelegt wurde
| CVE | Worum es geht | Betroffenes nginx OSS | Behoben in |
|---|---|---|---|
| CVE-2026-123007 | Integer Underflow in der HTTP/2-Flusskontrolle (send_window) | 1.9.5 bis 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
| CVE-2026-123633 | Use-after-free einer HTTP/2-Verbindung im Reverse-Proxy-Modus | 1.19.7 bis 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
send_window)Beide sind als kritisch eingestuft, mit einem CVSS-4.0-Score von 9.2. Dasselbe Release schloss außerdem 8 weitere CVEs in HTTP/3, im Mail-Proxy, im DNS-Resolver und in den Stream-Modulen.
Die Ausnutzung ist schwierig: Sie erfordert ein Speicherleck und gezieltes Heap Grooming, und Wiz hat seinen Exploit-Code nicht veröffentlicht, auch wenn einige Security-Anbieter bald öffentliche Exploits meldeten. Wir haben die Lage trotzdem als dringend behandelt. Die Fehler erlauben Remote Code Execution ohne Authentifizierung, HTTP/2 war auf fast allen unseren öffentlichen Endpunkten aktiv, und TLS-Terminatoren halten private Schlüssel im Speicher. Wir haben entschieden, innerhalb von 1 bis 2 Tagen zu patchen, statt auf das nächste Wartungsfenster zu warten.
👉 Vollständige technische Analyse: NGINX HTTP/2 RCE vulnerabilities, Wiz Research
Unsere Reaktion, Schritt für Schritt
1. Zuerst die Angriffsfläche erfassen
Bevor wir irgendetwas angefasst haben, haben wir die gesamte Infrastruktur im Read-only-Modus durchsucht: Edge-Routing, TLS-Terminierung, interne Dienste und die Kubernetes-Ingress-Controller. Für jede Instanz haben wir die nginx-Version notiert und ob HTTP/2 aktiv war.
So entstand eine Prioritätenliste auf Basis der tatsächlichen Exponierung. Dabei fielen auch einige interne Hosts mit jahrealten nginx-Versionen auf.
2. Versteckte Abhängigkeiten finden
Ein nginx-Upgrade ist selten nur ein nginx-Upgrade.
Unsere Builds enthalten eigene dynamische Module für Metriken, Geolokalisierung und WAF, und nginx lädt nur Module, die für genau seine Version gebaut wurden. Jedes Modul musste für 1.30.7 neu gebaut werden, und zwar für jede CPU-Architektur, die wir betreiben.
ARM war der heikle Teil: Unser dedizierter ARM-Build-Runner war eine Woche zuvor außer Betrieb genommen worden. Wir haben diese Builds auf emulierte Cross-Builds in der gemeinsamen CI verlagert. Jeder dauerte bis zu 25 Minuten statt ein paar Minuten. Das war lästig, erforderte aber keine neue Hardware.
3. Backport, wenn ein Upgrade keine Option ist
Unser Kubernetes-Ingress-Controller basiert auf einem eingefrorenen Upstream, der seine nginx-Version festschreibt und Dutzende eigener Patches mitbringt. Ihn auf nginx 1.30 umzustellen, wäre ein eigenes Projekt gewesen.
Deshalb haben wir den offiziellen Security-Diff zwischen nginx 1.30.6 und 1.30.7 genommen und auf das nginx des Controllers angewendet. Er ließ sich sauber über alle Upstream-Patches legen, die eine unscharfe Stelle haben wir von Hand geprüft. Der Versionsstring lautet weiterhin 1.27.1, der HTTP/2-Code darunter entspricht jedoch 1.30.7.
4. Über Review ausliefern, nach Blast Radius ausrollen
Jede Änderung lief über einen Merge Request mit automatisiertem Code- und Security-Review: Modulpakete, die Installationsrolle, das Ingress-Image, die Versions-Pins. Hosts, die über unsere Playbooks verwaltet werden, wurden ausschließlich über diese Merge Requests geändert.
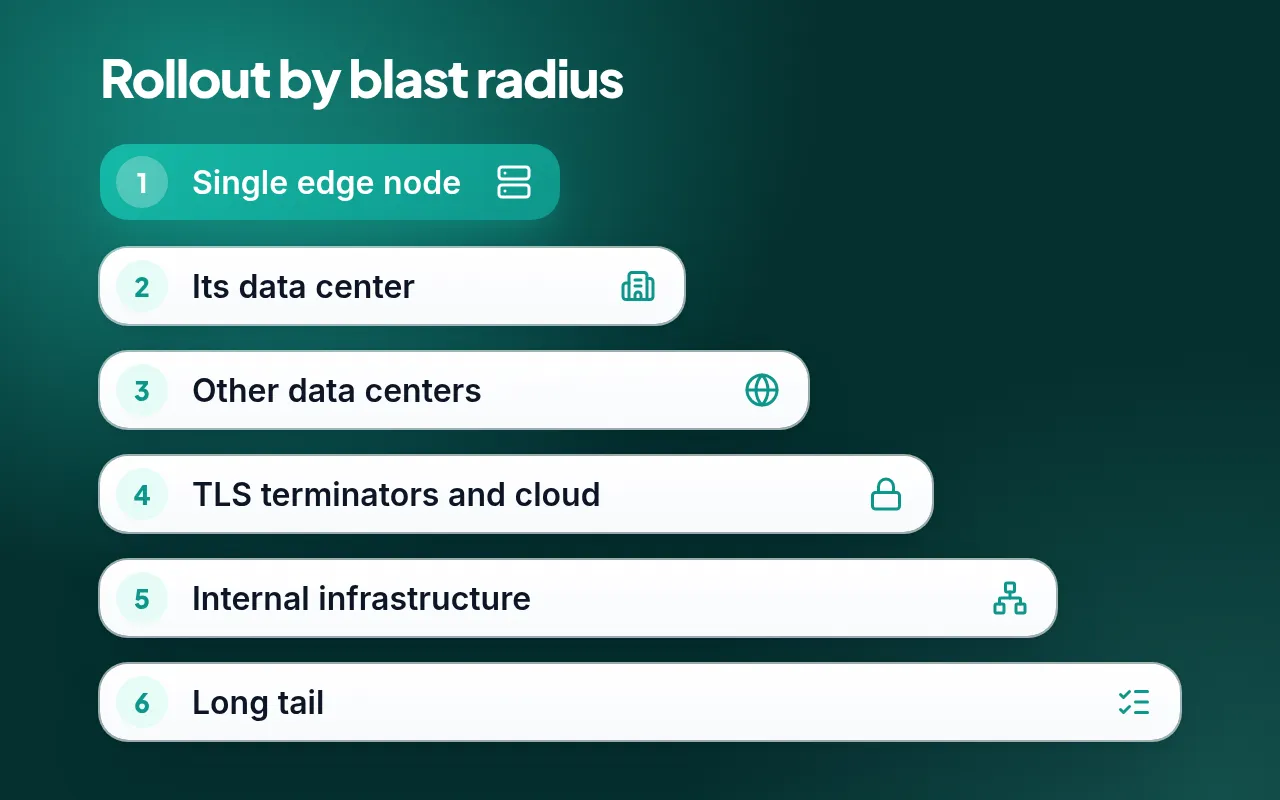
Wir haben Host für Host ausgerollt und dort begonnen, wo ein Fehler am wenigsten Schaden anrichten würde. Zuerst ein einzelner Edge-Knoten in einem Rechenzentrum, von außen über HTTP/2 geprüft. Dann der Rest dieses Rechenzentrums, die übrigen Rechenzentren, TLS-Terminatoren und Cloud-Hosts, zuletzt der Bastion-Host für den Zugang.
Auf jedem Host führte das Playbook den Konfigurationstest vor und nach der Änderung aus, startete nginx nur neu, wenn sich das Binary geändert hatte, und bestätigte, dass das neue Binary mit allen geladenen Modulen lief, der TLS-Handshake funktionierte und das Error-Log sauber war.
Der Kubernetes-Ingress wurde über Helm ausgerollt. Vor dem Apply haben wir das laufende Release mit git abgeglichen und einen serverseitigen Dry Run ausgeführt. Die neuen Controller ersetzten die alten Knoten für Knoten.
5. Den Long Tail schließen
Einige Hosts lagen außerhalb unserer zentralen Automatisierung, vor allem interne Tools und VPN-Knoten mit Distributionspaketen. HTTP/2 abzuschalten wäre die schnelle, offiziell empfohlene Übergangslösung gewesen. Es stellte sich jedoch heraus, dass für jede von uns genutzte OS-Version gepatchte Pakete existierten. Also haben wir auch diese Hosts auf 1.30.7 aktualisiert, einzeln und jeweils nach einem Backup der Konfiguration.
Sie brachten eigene Überraschungen mit. Alte Modulpakete der Distribution mussten zuerst entfernt werden, sonst scheiterte das neue nginx am Konfigurationstest. Der alte Prozess bediente währenddessen weiter den Traffic, es gab also keinen Ausfall. Einige Knoten brauchten vor dem Upgrade außerdem ein neueres OpenSSL.
Der Fund, über den wir am meisten froh sind: 1 Provisioning-Rolle hatte eine alte nginx-Standardversion und erlaubte Downgrades. Ihr nächster Routinelauf hätte den Fix unbemerkt zurückgerollt. Ein separater Merge Request schreibt die Version jetzt im Code fest.
💡 Prüfen Sie nach jedem manuellen Fix, dass Ihre eigene Automatisierung ihn nicht rückgängig macht.
Wie die Arbeit organisiert war
1 DevOps-Engineer hat die Reaktion gemeinsam mit KI-Agenten gesteuert, die jeweils für einen eng umrissenen Teil des Prozesses zuständig waren: Ausführung, Aufgabenverteilung, Code-Review, Releases und Freigabe von Zugängen. Die Agenten übernahmen die repetitive, leicht überprüfbare Arbeit wie Bestandsaufnahme, Builds, Merge Requests, Rollout und Prüfungen nach der Änderung.
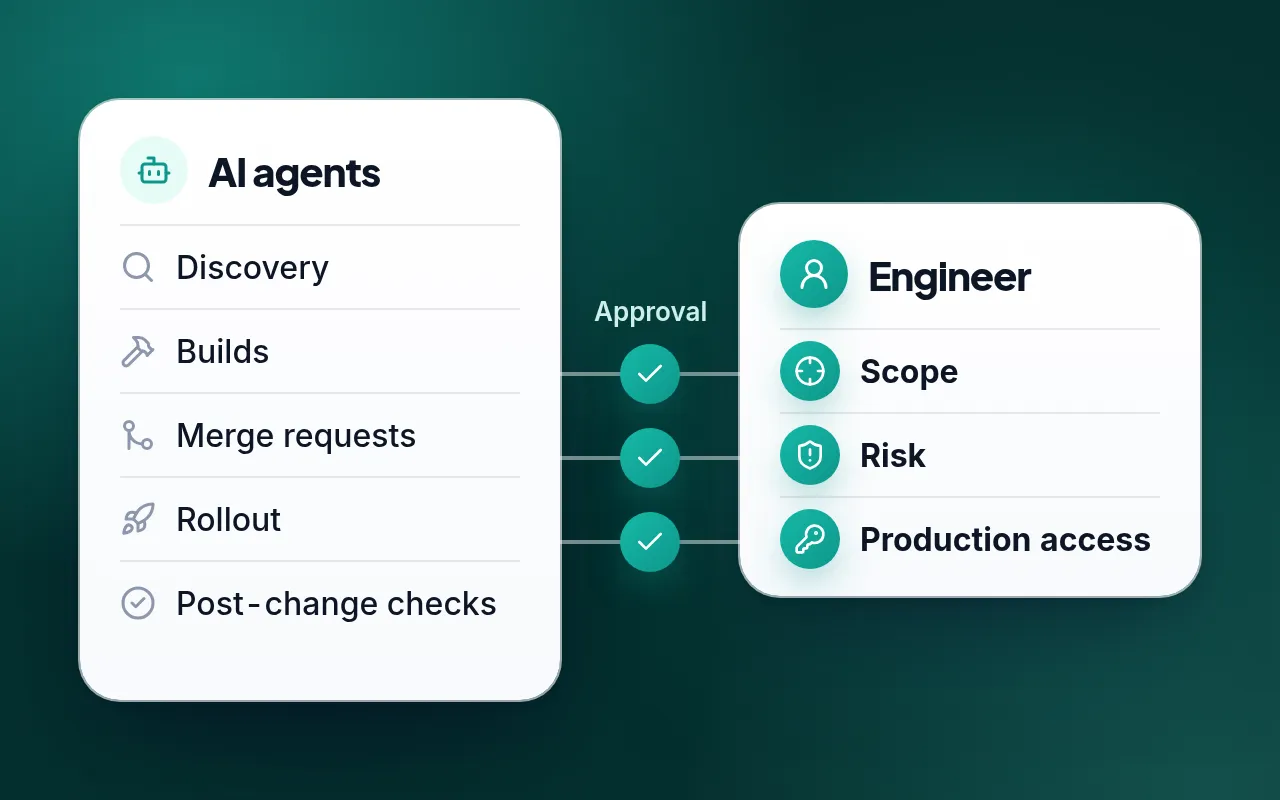
Die Entscheidungen blieben beim Engineer. Umfang, Risiko und Produktionszugang lagen in seiner Hand, und der Umfang wuchs nur nach seiner ausdrücklichen Freigabe im Team-Thread.
Für Zugänge galt dasselbe Modell. Erweiterte Zugriffsrechte wurden pro Arbeitsphase vergeben, nicht pro Befehl, erst nach Freigabe durch den Engineer, und sie liefen ab, sobald das Arbeitsfenster geschlossen war.
Diese Aufteilung hat die Umsetzung an einem Tag möglich gemacht: 1 Person konnte die gesamte Infrastruktur abdecken, während jede Änderung trotzdem durch ein Review und eine menschliche Entscheidung ging.
Das Ergebnis
| Wann | Was passiert ist |
|---|---|
| 18. Nov. | F5 veröffentlicht Fixes, die Schwachstellen werden öffentlich bekannt |
| 19. Nov., morgens | Engineer teilt die Wiz-Analyse, die Erfassung der Angriffsfläche beginnt |
| 19. Nov., mittags | Module für alle Architekturen neu gebaut, Ingress-Image per Backport gepatcht, Änderungen reviewt und gemergt |
| 19. Nov., nachmittags | Gestaffelter Rollout: Edge, TLS-Terminatoren, Cloud-Hosts, Bastion, interne Tools und VPN-Knoten |
| 19. Nov., Tagesende | Jede öffentlich erreichbare nginx-Instanz der Pushwoosh-Plattform gepatcht und geprüft |
| 20. Nov. | Internes Audit ohne Anzeichen einer Ausnutzung abgeschlossen, Sicherheitshinweis auf der Statusseite veröffentlicht |
- Mehr als 30 Hosts auf nginx 1.30.7 umgestellt und live geprüft, einschließlich ARM-Maschinen.
- Der Ingress in beiden Kubernetes-Produktionsclustern von Pushwoosh läuft mit dem Backport-Image.
- Ein am 20. November abgeschlossenes internes Audit fand keine Anzeichen einer Ausnutzung.
Was das für Pushwoosh-Kunden bedeutet
Für die Pushwoosh-Plattform ist auf Ihrer Seite nichts zu tun, und unsere Mobile und Web SDKs sind nicht betroffen. Details finden Sie in unserem Sicherheitshinweis auf der Statusseite. Das vollständige Security Advisory PW-SA-2026-003 erhalten Sie auf Anfrage unter support@pushwoosh.com.
Wenn Ihre eigenen Systeme nginx, NGINX Plus oder ingress-nginx mit aktiviertem HTTP/2 betreiben, empfehlen wir ein Update auf nginx 1.30.7, 1.31.9 oder neuer.
Was wir jedem Team mitgeben würden
- Kennen Sie Ihre Angriffsfläche, bevor Sie sie brauchen. Unsere erste Stunde ging auf die Frage „Welche Systeme sind betroffen?“. Mit einem aktuellen Inventar von Versionen und Einstellungen dauert das Minuten.
- Dynamische Module sind eine versteckte Abhängigkeit jedes Patches. Planen Sie Zeit für den Neubau jedes Moduls und jeder Architektur ein, bevor Sie das Upgrade terminieren, besonders für eine Architektur ohne eigenen Build-Runner.
- Der Backport eines Security-Diffs ist ein legitimes Werkzeug. Wenn ein eingefrorener Upstream das Upgrade blockiert, kann der offizielle Fix, angewendet auf die bereits laufende Version, das Risiko noch am selben Tag schließen.
- Stellen Sie sicher, dass die Automatisierung Ihren Fix nicht rückgängig macht. Suchen Sie nach Rollen mit einer Standardversion und erlaubten Downgrades. Eine unserer Rollen hätte beim nächsten Routinelauf einen Tag Arbeit zurückgedreht.
- Lassen Sie Menschen über den Umfang entscheiden und befristen Sie Zugänge. 1 befristete Zugriffsfreigabe pro Phase statt pro Befehl bedeutet weniger Freigabeklicks, und der Zugang verschwindet, sobald die Arbeit erledigt ist.
Kundenvertrauen schützen mit Pushwoosh
Bei der Reaktion auf eine kritische CVE geht es nicht darum, wie schnell jemand tippen kann. Es geht darum, Inventar, Pipeline und Review-Prozess bereit zu haben, bevor das Advisory erscheint.
Dieselbe Disziplin wenden wir auf alles an, was über Pushwoosh läuft, einschließlich Ihrer Nachrichten und Nutzerdaten. Wenn Sie Details dazu wünschen, wie wir die Sicherheit Ihrer App gewährleisten, sprechen Sie mit unserem Team.
Verwandte Artikel
Alle anzeigen