Le 18 novembre 2026, des chercheurs en sécurité ont révélé 2 vulnérabilités critiques dans nginx, l’un des serveurs web les plus utilisés sur Internet. Toutes les versions de nginx publiées depuis dix ans sont concernées : les entreprises du monde entier qui l’utilisent avec HTTP/2 activé ont dû mettre à jour.
Le lendemain matin, l’un de nos ingénieurs DevOps a partagé l’analyse de Wiz Research avec l’équipe et demandé quels systèmes devaient être mis à jour. À la fin de cette journée de travail, chaque instance nginx exposée à Internet desservant la plateforme Pushwoosh était mise à jour et vérifiée. Un audit interne mené le jour suivant n’a relevé aucun signe d’exploitation.
Pushwoosh est une plateforme d’engagement client omnicanal, et les applications de nos clients envoient du trafic API via notre edge en continu. Quand une faille de serveur web de ce type devient publique, la rapidité avec laquelle nous la corrigeons compte pour chacun d’eux. Voici ce qui a été révélé, ce que nous avons fait, comment un ingénieur et un ensemble d’agents IA se sont réparti le travail, et ce que nous en avons retenu.
Ce qui a été révélé
| CVE | De quoi il s'agit | nginx OSS concerné | Corrigé dans |
|---|---|---|---|
| CVE-2026-123007 | Dépassement inférieur d'entier dans le contrôle de flux HTTP/2 (send_window) | 1.9.5 à 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
| CVE-2026-123633 | Use-after-free d'une connexion HTTP/2 en mode reverse proxy | 1.19.7 à 1.31.8 | 1.30.7 (stable), 1.31.9 (mainline) |
send_window)Les deux sont classées critiques, avec un score CVSS 4.0 de 9.2. La même version a aussi corrigé 8 autres CVE dans HTTP/3, le proxy mail, le résolveur DNS et les modules stream.
L’exploitation est difficile : elle exige une fuite mémoire et une préparation minutieuse du tas (heap grooming), et Wiz n’a pas publié son code d’exploitation, même si certains éditeurs de sécurité ont rapidement signalé des exploits publics. Nous l’avons tout de même traitée comme une urgence. Ces failles permettent l’exécution de code à distance sans authentification, HTTP/2 était activé sur presque tous nos points de terminaison publics, et les terminateurs TLS conservent les clés privées en mémoire. Nous avons décidé de corriger sous 1 à 2 jours plutôt que d’attendre la prochaine fenêtre de maintenance.
👉 Analyse technique complète : NGINX HTTP/2 RCE vulnerabilities, Wiz Research
Notre réponse, étape par étape
1. Cartographier d’abord l’exposition
Avant de toucher à quoi que ce soit, nous avons passé en revue toute l’infrastructure en lecture seule : routage edge, terminaison TLS, services internes et contrôleurs ingress Kubernetes. Pour chaque instance, nous avons noté la version de nginx et si HTTP/2 était activé.
Nous avons ainsi obtenu une liste de priorités fondée sur l’exposition réelle. Elle a aussi fait apparaître quelques hôtes internes tournant sur des versions de nginx vieilles de plusieurs années.
2. Trouver les dépendances cachées
Mettre à jour nginx, c’est rarement seulement mettre à jour nginx.
Nos builds embarquent des modules dynamiques personnalisés pour les métriques, la géolocalisation et le WAF, et nginx ne charge qu’un module compilé pour sa version exacte. Chaque module devait être recompilé pour 1.30.7, sur chaque architecture CPU que nous utilisons.
ARM était le point délicat : notre runner de build ARM dédié avait été retiré une semaine plus tôt. Nous avons basculé ces builds vers des cross-builds émulés dans la CI partagée. Chacun prenait jusqu’à 25 minutes au lieu de deux ou trois. C’était agaçant, mais cela ne demandait aucun nouveau matériel.
3. Rétroporter quand la mise à jour n’est pas possible
Notre contrôleur ingress Kubernetes repose sur un upstream figé qui fixe sa version de nginx et embarque des dizaines de correctifs maison. Le migrer vers nginx 1.30 aurait été un projet à part entière.
Nous avons donc pris le diff de sécurité officiel entre nginx 1.30.6 et 1.30.7 et l’avons appliqué au nginx du contrôleur. Il s’est appliqué proprement par-dessus tous les correctifs upstream, et nous avons vérifié à la main le seul passage approximatif. La chaîne de version indique toujours 1.27.1, alors que le code HTTP/2 sous-jacent correspond à 1.30.7.
4. Livrer via la revue, déployer selon le rayon d’impact
Chaque changement est passé par une merge request avec revue automatisée du code et de la sécurité : paquets de modules, rôle d’installation, image ingress, versions épinglées. Les hôtes gérés par nos playbooks n’ont été modifiés qu’au travers de ces merge requests.
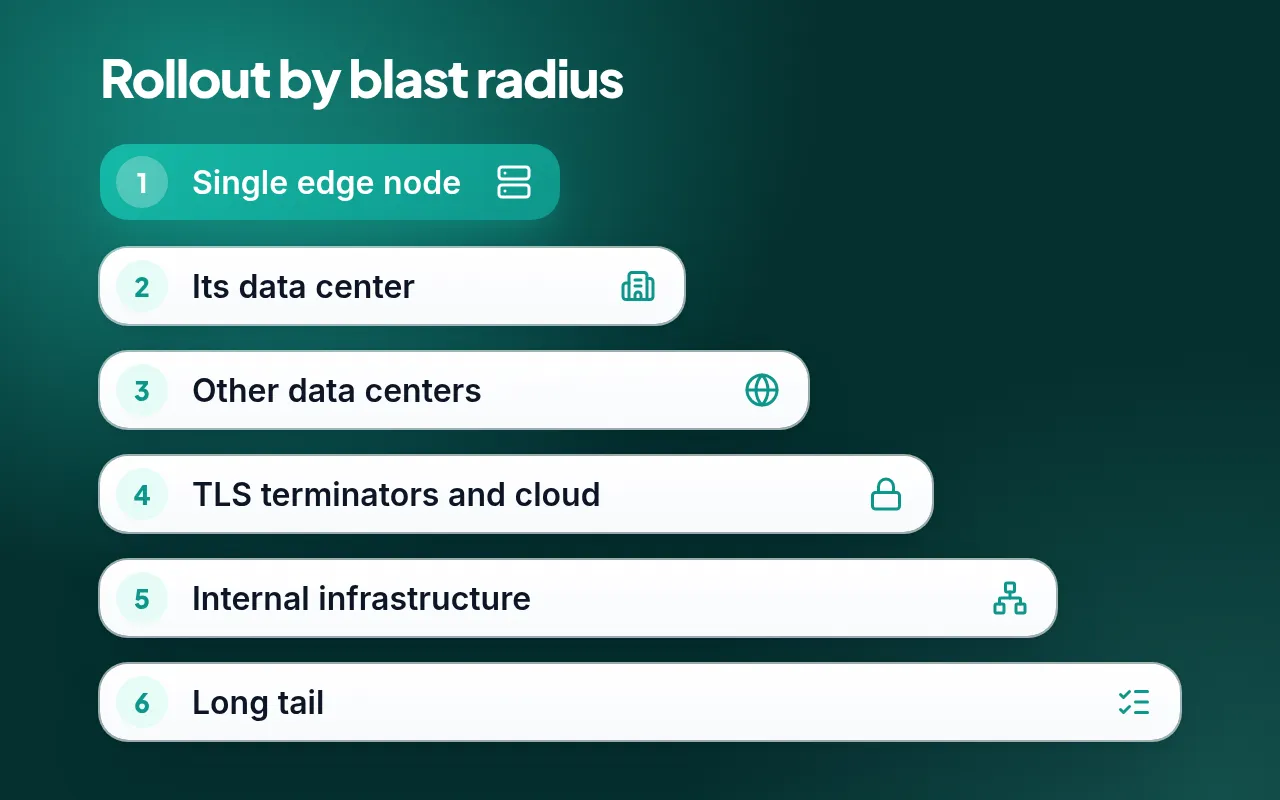
Nous avons déployé hôte par hôte, en commençant là où une panne ferait le moins de dégâts. D’abord un seul nœud edge dans un data center, vérifié depuis l’extérieur en HTTP/2. Puis le reste de ce data center, les autres data centers, les terminateurs TLS et les hôtes cloud, et en dernier le bastion d’accès.
Sur chaque hôte, le playbook exécutait le test de configuration avant et après, ne redémarrait nginx que si le binaire avait changé, et confirmait que le nouveau binaire tournait avec tous les modules chargés, un handshake TLS fonctionnel et un journal d’erreurs propre.
L’ingress Kubernetes a été déployé via Helm. Avant l’application, nous avons comparé la release en production avec git et lancé un dry run côté serveur, puis les nouveaux contrôleurs ont remplacé les anciens nœud par nœud.
5. Traiter la longue traîne
Quelques hôtes échappaient à notre automatisation principale, surtout des outils internes et des nœuds VPN utilisant les paquets de la distribution. Désactiver HTTP/2 aurait été la solution d’attente rapide et officiellement recommandée. Il s’est avéré que des paquets corrigés existaient pour chaque version d’OS que nous utilisons : nous avons donc aussi mis ces hôtes à jour en 1.30.7, un par un et après une sauvegarde de la configuration.
Ils ont réservé leurs propres surprises. Les anciens paquets de modules de la distribution devaient être retirés d’abord, sinon le nouveau nginx échouait au test de configuration. L’ancien processus a continué à servir le trafic pendant toute l’opération, sans aucune interruption. Quelques nœuds ont aussi eu besoin d’une version plus récente d’OpenSSL avant la mise à jour.
La découverte qui nous réjouit le plus : 1 rôle de provisioning avait une ancienne version de nginx par défaut et autorisait les rétrogradations. Sa prochaine exécution de routine aurait discrètement annulé le correctif. Une merge request distincte fixe désormais la version dans le code.
💡 Après tout correctif manuel, vérifiez que votre propre automatisation ne va pas l’annuler.
Comment le travail était organisé
1 ingénieur DevOps a piloté la réponse avec des agents IA, chacun responsable d’une partie précise du processus : exécution, répartition des tâches, revue de code, releases et validation des accès. Les agents ont pris en charge le travail répétitif et facile à vérifier : inventaire, builds, merge requests, déploiement et vérifications après changement.
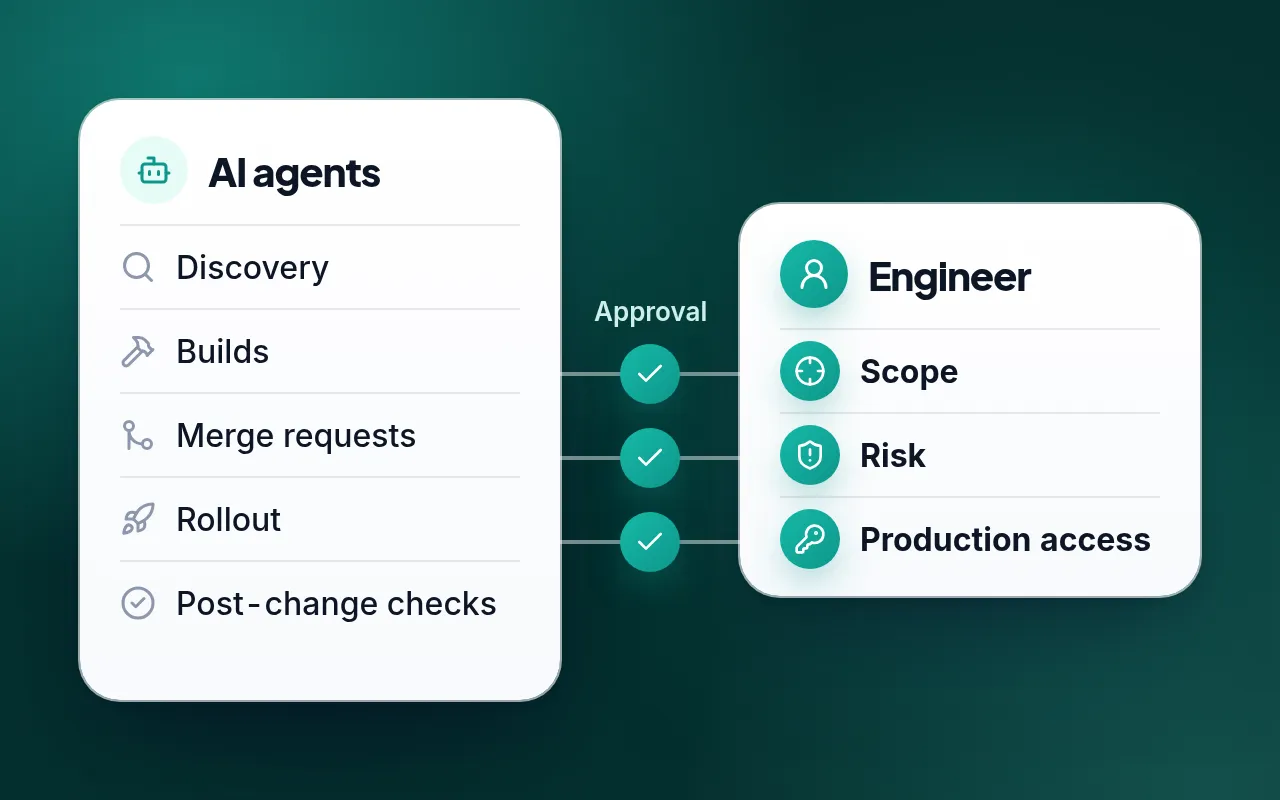
Les décisions sont restées entre les mains de l’ingénieur. Le périmètre, le risque et l’accès à la production relevaient de lui, et le périmètre ne s’est élargi qu’après son feu vert explicite dans le fil de discussion de l’équipe.
Les accès suivaient le même modèle. Les droits élevés étaient accordés par étape de travail, et non par commande, uniquement après validation de l’ingénieur, et ils expiraient à la fermeture de la fenêtre de travail.
C’est cette répartition qui a permis de tout boucler en une journée : 1 seule personne pouvait couvrir toute l’infrastructure, tandis que chaque changement passait quand même par une revue et une décision humaine.
Le résultat
| Quand | Ce qui s'est passé |
|---|---|
| 18 nov. | F5 publie les correctifs, les vulnérabilités sont rendues publiques |
| 19 nov., matin | L'ingénieur partage l'analyse de Wiz, la cartographie de l'exposition commence |
| 19 nov., mi-journée | Modules recompilés pour toutes les architectures, image ingress rétroportée, changements revus et mergés |
| 19 nov., après-midi | Déploiement par étapes : edge, terminateurs TLS, hôtes cloud, bastion, outils internes et nœuds VPN |
| 19 nov., fin de journée | Chaque instance nginx exposée à Internet desservant la plateforme Pushwoosh corrigée et vérifiée |
| 20 nov. | Audit interne terminé sans signe d'exploitation, avis de sécurité publié sur la page de statut |
- Plus de 30 hôtes passés en nginx 1.30.7 et vérifiés en production, machines ARM comprises.
- L’ingress des deux clusters Kubernetes de production de Pushwoosh tourne sur l’image rétroportée.
- Un audit interne terminé le 20 novembre n’a relevé aucun signe d’exploitation.
Ce que cela signifie pour les clients Pushwoosh
Aucune action n’est requise de votre part pour la plateforme Pushwoosh, et nos SDK Mobile et Web ne sont pas concernés. Les détails figurent dans notre avis de sécurité sur la page de statut, et le Security Advisory complet PW-SA-2026-003 est disponible sur demande à support@pushwoosh.com.
Si vos propres systèmes utilisent nginx, NGINX Plus ou ingress-nginx avec HTTP/2 activé, nous vous recommandons de passer à nginx 1.30.7, 1.31.9 ou une version ultérieure.
Ce que nous conseillerions à toute équipe
- Connaissez votre exposition avant d’en avoir besoin. Notre première heure a servi à répondre à la question «quels systèmes sont concernés». Avec un inventaire à jour des versions et des paramètres, cela prend quelques minutes.
- Les modules dynamiques sont une dépendance cachée de chaque correctif. Prévoyez le temps de recompilation de chaque module et de chaque architecture avant de planifier la mise à jour, surtout pour une architecture sans runner de build dédié.
- Rétroporter un diff de sécurité est un outil légitime. Si un upstream figé bloque la mise à jour, appliquer le correctif officiel à la version que vous utilisez déjà peut éliminer le risque le jour même.
- Assurez-vous que l’automatisation n’annulera pas votre correctif. Cherchez les rôles avec une version par défaut et des rétrogradations autorisées. L’un des nôtres aurait annulé une journée de travail à sa prochaine exécution de routine.
- Laissez les décisions de périmètre aux humains et limitez les accès dans le temps. 1 accès temporaire par étape, et non par commande, signifie moins de clics de validation, et l’accès disparaît une fois le travail terminé.
Protégez la confiance de vos clients avec Pushwoosh
Répondre à une CVE critique, ce n’est pas une question de vitesse de frappe. C’est avoir l’inventaire, le pipeline et le processus de revue prêts avant la publication de l’advisory.
Nous appliquons la même rigueur à tout ce qui passe par Pushwoosh, y compris vos messages et les données de vos utilisateurs. Pour en savoir plus sur la manière dont nous gérons la sécurité de votre application, parlez-en à notre équipe.
Articles connexes
Tout voir